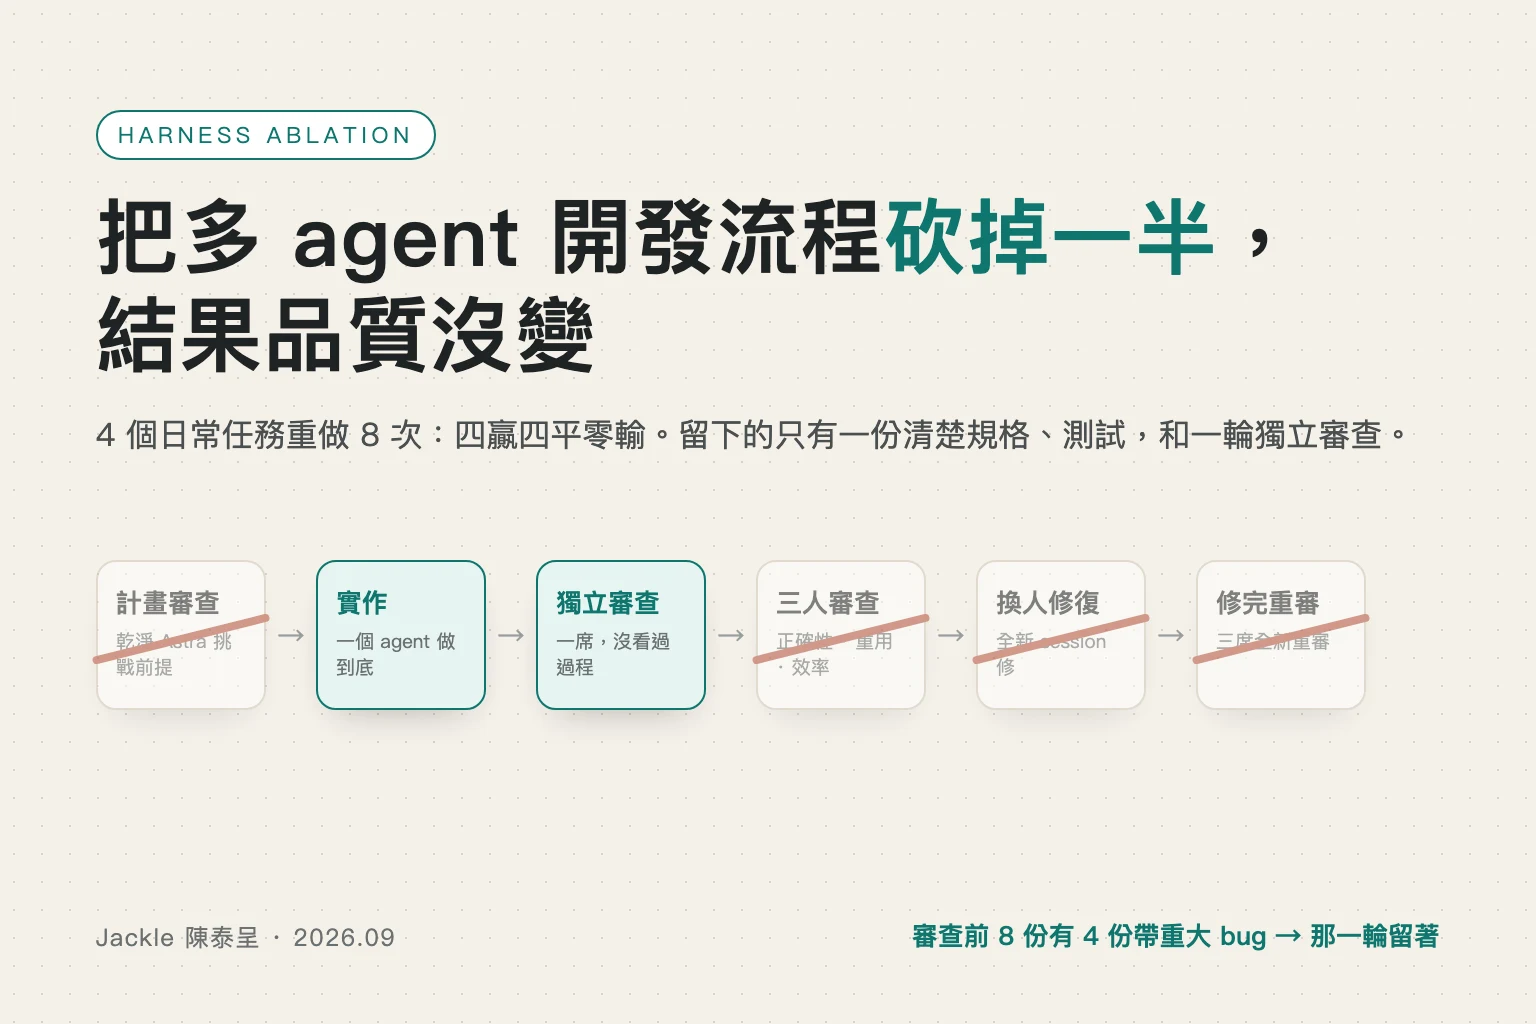
我把自己的多 agent 開發流程砍掉一半,結果品質沒變
我現在想做的是,把流程砍到只剩基本約束和測試,讓一個 agent 把事情做完,再交給另一個獨立 agent 審查。 規格要清楚、專案規範要讀、測試要寫,也要檢查有沒有多做。至於計畫審查、三人互審、換人修完再重審,日常任務先拿掉。
這個想法來自我自己做的一次對照實驗。先把實驗結果濃縮成四句,細節後面逐段講:
4 個任務 × 2 次重做
拿四個日常任務用精簡流程各重做兩次,共八份成品,跟原本完整流程的成品對比。
4 贏 4 平 0 輸
遮住來源讓評審比兩份成品,精簡版補完獨立審查後沒有一次輸,花的時間也更少。
審查前一半帶著重大 bug
八份裡有四份在被審查前有會讓使用者看到錯誤的缺陷,所以獨立審查這一輪我會留。
高風險任務沒測
金流、權限、狀態機、資料遷移的任務不在樣本裡,暫時維持原流程。
起點:看到 Uncle Bob 回頭拆自己的框架
起因是我看到蕭上農這篇 Facebook 貼文,在講 Clean Code 作者 Uncle Bob Martin 對自己多 agent 框架的反思。Uncle Bob 的 X 原始貼文在這裡。
照 Facebook 貼文的轉述,他花了幾個月打造多 agent 編排框架,設計交接流程、隔離 Context,還加上程式碼品質檢查。後來他拿掉大部分框架限制,讓單一 Grok agent 處理難度相近的任務,結果反而更快,產出的程式碼和測試品質也更好。
他在 9 月 11 日的另一篇 X 貼文裡,把這個反思講得更清楚。他說自己花了好幾週做 harness,加上各種關卡和工具,想讓 agent 照他的方式工作。結果埋頭把框架做好的這段時間,agent 已經進步了一大截,他開始懷疑還需要多少限制。
他沒有說「什麼都不用」
- unit testing、CRAP 和 mutation testing 仍然有用,這些工具還是抓得到 bug。
- 他現在可以只給幾條指引,讓一個 agent 做相當大的任務,離開 40 分鐘回來,通常就做完了。成品不保證完全符合預期,有時還要調整幾下。
- 跟 Grok 和 Codex 討論架構,已經像在跟資深工程師辯論。它們會有自己的看法,會不同意他,而他不只一次被說服。所以他開始想,harness 裡的 agent 還適合被當成軟體設計裡照規定運作的元件嗎?這個問題他也還沒有定論。
這讓我想到自己的開發流程:我加了這麼多關卡,到底有多少還需要?
我自己的專案無為和大掌櫃,是一個公司內部用的 AI 知識協作平台,由我一個人開發。一個任務從規格做到合併進主線,中間至少經過五道關卡。這些規則都是過去幾個月踩雷後加上去的,每一條我都說得出當初為什麼要加。
但模型一直在進步,我沒有回頭量過:當初需要的規則,現在拿掉會怎樣?所以我決定拿自己的任務做一次對照實驗。別人的結果可以拿來提醒自己,我的流程還是得自己測。
我原本的流程長什麼樣
先交代一下,我平常到底讓 AI 跑多少流程。我用兩家的模型分工:Claude 家的 Fable 5 當總指揮,負責判斷哪些問題該修、什麼時候可以放行;OpenAI 的 GPT-6 Astra 負責寫程式、審程式、修程式。一個日常任務的完整路徑是這樣:
| 站 | 誰做 | 做什麼 |
|---|---|---|
| 1 計畫審查 | 沒看過討論脈絡的 Astra | 只讀不改,專門挑戰前提。重大質疑要先解決才能開工 |
| 2 實作 | 一個 Astra,獨立工作目錄 | 照規格寫程式和測試。任務單附「刪減檢查」:每個新加的函式、參數、分支逐一拿掉再跑測試,仍綠且沒有驗收條件需要它就刪掉,防止 AI 寫出用不到的東西 |
| 3 三人審查 | Fable 一席+Astra 兩席 | 彼此獨立、互相看不到意見。Fable 看正確性,Astra 分別看「重複造輪子」和「效率」。三人都看完整改動 |
| 4 換人修復 | 另一個全新的 Astra | 不讓寫出 bug 的那個 session 自己修,因為它帶著同樣的誤解 |
| 5 修完重審 | 三席全新 session | 再審一輪,直到沒有重大問題 |
| 6 範圍對照、真機驗收、合流 | — | 不在本次實驗範圍 |
看完貼文,我最想拆掉試試的就是第 1、3、4、5 步。先限定在日常任務,看看少了這幾道關卡,做出來的東西會不會變差。
實驗怎麼設計
拿什麼來測
我拿了最近剛完成的四個任務來測。都是前端為主的日常任務:聊天錯誤提示、會議分享對話框、白板自動排版、會議篩選器。不碰金流、權限、狀態機、資料遷移。四個任務原本走完整流程各花了一到兩小時,審查都跑了兩到三輪。
選已經做完的任務有一個好處:原本流程的結果不用重跑,程式碼改動、每一輪審查記錄、花的時間都留在 git 和進度檔裡。缺點是它是兩週前的歷史紀錄,不是跟實驗同時做的,這點後面會再講。
兩種做法怎麼定義
每個任務用精簡做法各做兩次,兩次完全獨立、互相看不到。只做一次太容易被運氣決定,如果兩次都犯同樣的錯,就值得往下查。
怎麼讓比較公平
規格先清乾淨
原始規格裡有「計畫審查免跑,實作審查三人照跑」這種流程痕跡,會讓做精簡版的 Astra 知道自己在被比較。這類句子全部拿掉,只留純規格。
從同一個起點開始
每個任務精簡版的工作目錄,都從原本那個任務當初開工時的版本建出來。精簡版看到的程式碼跟原本開工時一模一樣。
只比程式碼
精簡版的 Astra 有時會順手改文件,比較前把文件部分剔掉。有一個任務第一次忘了做這步,精簡版因為多改了文件被判贏,剔掉重評後變平手。
每個 AI 釘死自己的目錄
之前踩過兩個 AI 同時改同一個目錄互相覆蓋的雷。這次九個工作目錄同時在跑,任務單第一句就是「先確認你在哪個目錄」。
用三種方式檢查結果
中間多加了一站
原本精簡版的設計是純一個人做到底。但第一個任務就讓我發現,精簡版的 Astra 自己回報全綠、事先寫好的驗收測試也全過,可是改動裡有東西看起來不對。
所以我在精簡版流程裡加了一站:實作完先把改動拍一份「審查前快照」存起來,派一個只讀不改、沒看過任何脈絡的 Astra 審一輪。有重大問題就交回原本那個實作者修,修完再拍「最終快照」。
結果
整體
| 問題 | 原本的做法(4 個任務) | 精簡的做法(4 個任務各做 2 次,共 8 份) |
|---|---|---|
| 規格要求的功能有做到嗎?(用事先寫好的驗收測試去跑) | 4 份全部通過 | 8 份全部通過 |
| 兩份成品放在一起比,哪份比較好?(評審不知道哪份是誰做的) | — | 精簡版 4 次贏、4 次平手、0 次輸 |
| 原本的三個審查者去審精簡版的最終成品,有找到嚴重問題嗎? | 原本做法自己第一輪審查抓到 2 個 | 0 個 |
| 精簡版在「還沒被任何人審查」的時候,有嚴重問題嗎? | — | 8 份裡有 4 份有 |
| 花了多少時間? | 當作 100% | 原本的 14% 到 86% |
這張表要分開看
精簡版最後的成品沒有比較差,但那是經過獨立審查、修完之後的結果。審查前,有一半帶著重大問題。
發現一:最後做出來的東西,品質沒有差別
驗收測試兩邊全過。評比精簡版四贏四平零輸。原本的三人審查去掃精簡版八份最終成品,重大問題零個,只有三個「測試有點重複」「少一層防禦」這種等級的中等問題。
評比精簡版贏的那四次,理由都指向測試品質。精簡版的測試是從「使用者送出訊息」一路走到「畫面上的對話泡泡」,原本版的測試有幾條是直接塞內部狀態、繞過真實路徑。我猜一個人從頭做到尾,比較容易把測試接在完整的使用路徑上。不過這次沒有單獨驗證原因,不能直接算成精簡流程的功勞。
發現二:用時約為原本的 14% 到 86%
最省的是會議分享對話框那個任務,原本流程花了兩個多小時跑三輪審查加計畫審查,精簡版兩次都在 20 分鐘內做完、審查前快照零問題。最不省的是白板排版那個任務,因為審查抓到重大問題之後,修復又花了一輪。
要提醒的是兩邊的時間量法不對稱:原本版是歷史紀錄的下限,精簡版是各任務加總。可以看出這次精簡版比較快,但別把這個區間當成下個任務也能省的時間。
發現三:審查前的快照,八份裡有四份有重大問題
這是我覺得最值得看的結果。如果只看最終成品,會得到「多人審查沒用」的結論。但如果看審查前的快照,八份裡有四份帶著會讓使用者看到錯誤行為的缺陷。而且是同一個任務,兩次獨立重做都犯一樣的錯:
聊天錯誤提示:超限提示被自動重試蓋掉
規格要求後端回「聊天名額超限」時,前端顯示專屬的提示文字。兩次的實作者都正確接了錯誤碼跟文字,也都寫了測試、測試全綠。
但既有的連線重試機制把「超限」當成可以重試的錯誤,實際使用者會看到提示閃一下,然後被自動重試蓋掉,重試三次用完才停下來。事先寫好的驗收測試看不到這件事,因為測試把連線那層模擬掉了。原本流程當初也是第一輪由 Fable 抓到一模一樣的問題。
白板排版:「刪減檢查」把必要的快取刪掉了
白板整理版面是分層的遞迴演算法,計算深度要用快取,不然 36 張卡片會爆炸式重複計算,按下去整個畫面卡死。原本做法的實作從第一版就有快取。
精簡版的兩個實作者一開始也都寫了快取,然後在做「刪減檢查」時把它拿掉試試,測試還是綠的,於是照規則刪了。兩位在修復時的自述都是「刪減檢查只驗了功能、沒驗效能」。
我寫給 AI 的規則本身有洞
功能測試看不到執行速度和記憶體,「測試仍綠就刪」用在快取、索引、去重複這類東西上是錯的。原本任務的完整流程有攔下這個問題。這次拿掉審查,兩次獨立重做都踩中同一個洞。
四份帶重大問題的快照,全部被那一輪獨立審查抓到。抓到的東西跟原本流程三人審查抓到的一模一樣。
發現四:三個審查者裡,有兩個幾乎沒事做
八份成品各審三人,共 24 次審查:
看正確性的 Fable
每次都有意見,但都是中等以下,因為重大問題已經被前面那一輪獨立審查抓完了。
看「重複造輪子」的 Astra
八次只提了兩個輕微問題。
看效率的 Astra
八次零產出。
這跟我的直覺相反。我原本以為「看效率」的那個會是抓到快取問題的人,結果是看正確性的審查者用記憶體探針實測抓到的。
我的結論
Uncle Bob 的案例讓我想回頭檢查自己的流程。這四個任務的結果是,少了計畫審查與反覆的三人審查,再讓原本的實作者自己修,最終成品並沒有比較差。原本花在這些關卡上的時間,有一部分可以省下來。
不過我的實驗也多看到一件事:一個 agent 做到底,八份裡有四份帶著自己的測試抓不到的 bug。這次靠一個沒看過實作過程的審查者,就把這四份的重大問題抓出來了。所以我先保留這一輪。至少在這八次重做裡,它確實有抓到東西;後面再加三人審查,沒有多抓到重大問題。
還有一個副產品:「刪減檢查」的規則補了一句。會改變執行速度或記憶體用量的東西,例如快取、索引、去重複,視同驗收條件需要,要保留,並補一條拿掉它就會紅的測試。
決定與落地
實驗當天,我就把日常任務的流程改了。今天起有兩條路:日常任務走精簡路線,高風險任務走完整路線。
-
日常任務的實作審查改成一個獨立 Astra 審一輪
原本三人審查裡的 Fable 那一席改成「照跑但不擋任務」,只記錄結果。另外兩席實驗裡幾乎沒產出,直接拿掉。
-
日常任務不跑計畫審查
原本計畫審查負責的「有沒有照規格做」,併進那一輪獨立審查,逐條驗收條件對照實作。
-
高風險任務維持完整流程不動
碰金流、權限、狀態機、資料遷移的任務,之後另外做同樣的實驗。
-
一個任務走哪條路由總指揮照清單自動判
分流的三個問題:以前端為主嗎?不碰金流、權限、狀態機、資料遷移嗎?改動不超過三個套件嗎?三個都是「是」才走精簡流程。判不準一律走完整流程,避免精簡流程的適用範圍越放越寬。
這四個決定已經寫進專案的規範檔,成為正式的「日常任務流程」。我也給自己留了退路:前十個日常任務,Fable 那一席照跑但不擋,只記錄。如果它抓到獨立審查漏掉的重大問題,那個任務記一個叉。累計兩個叉就停掉精簡流程、回到完整流程、重新檢討。
落地當天又砍了一輪 才剛叫它少做一點,它又幫我找了一堆事
實驗做完,我請 AI 把新的做法寫下來,讓之後的任務照著做。
結果它又加了一堆要求。原本要省掉的審查還是得跑,只是不影響任務繼續做,另外還要填一張十一欄的表。
我覺得太麻煩,就找另一個 AI 看看哪些可以不用做。最後五條要求刪了四條,剩下一條也改簡單了。
才剛叫它少做一點,它又幫我找了一堆事 XD。
這個實驗沒回答的事
這次結果的幾個限制
- 高風險任務完全沒有樣本。金流、權限、狀態機的任務沒進實驗,結論不能套過去。那類任務出錯的代價可能高得多。
- 樣本只有四個任務、八次重做。夠看趨勢,不夠下統計結論。十個任務的試行就是在補樣本。
- token 沒量到。時間省了不代表錢省了,一個人做到底的 AI 可能思考得更久。
- 原本做法是歷史紀錄。兩週前的模型版本、當時的程式碼狀態,跟今天都不完全一樣。
- 評審跟實作者是同一家模型。都是 Astra,評審偏好自家風格的可能性存在。不過四贏四平的結果主要來自測試品質,那個判準相對客觀。
我的主觀看法
我的開發流程是以 BMad method 為基底,再做了不少自己的改良。改良的方向一直是同一個:讓流程自動跑,並且減少「做出來的東西跟規格不符」這類狀況。計畫審查、三人審查、換人修復、修完重審、範圍對照,每一道都是為了堵某一種曾經發生過的錯。
做完這個實驗,我開始懷疑這些東西大部分可能都不需要了。至少這次的日常任務,一個 agent 可以從讀規格做到測試全綠,再補一輪獨立審查和修復,成品就沒有輸給原本的多人流程。有些關卡可能是在防舊模型的問題,只是我還沒逐條驗證。
我現在的想法是,只保留最基本的約束和測試,其他的都拿掉。什麼算最基本,我目前的清單是這樣:
一份寫清楚驗收條件的規格
後面的檢查都要靠它,實驗裡驗收測試、評比、審查全部靠它對照。規格不清楚,後面再多關卡都是在猜。
實作者開工前先讀專案規範
命名、目錄結構、哪些事不能做,這些不是流程,是專案本身的慣例。實驗裡精簡版也保留了這條。
實作者自己寫測試
實驗裡另外請人只看規格寫的獨立驗收測試一個嚴重問題都沒抓到,因為它把連線層模擬掉了。所以它不進流程,只當實驗工具。
一輪獨立審查
一個沒看過實作過程的審查者,看正確性、看有沒有照規格做、看有沒有多做。要給它我的原話和拍板時的畫面,不能只給轉寫過的驗收條件。
刪減檢查,補上效能的驗收條件
它讓 AI 不會留一堆用不到的抽象,但規則要補完整,不然會刪掉必要的快取。
範圍對照
每條規格條件指得到改動的行,每個改動追得回某條規格條件。它擋的是「做錯東西」,逐行審查看不到這種錯。由審查者做,不要實作者自己交表,自評容易自圓其說。
這份清單裡有些做法還沒單獨測過。目前的證據只有這四個日常任務,夠支持我先減少輪次,還不夠推到高風險任務。所以接下來分兩步:先用十個日常任務的試行補樣本,再拿金流和權限的任務做一次同樣的實驗。如果那邊的結果也一樣,整套流程會再往下砍。
回頭看,這幾個月我替 AI 加的每一道關卡,都是在某次踩雷後加上去的,加的當下都有道理。問題不在當初加,而在我沒有定期回頭問:模型進步了,這條規則還擋得到東西嗎?這次實驗給我的答案是,大部分已經擋不到了,只有一輪獨立審查還在真的抓 bug。
所以我現在的做法變成一句話:規格寫清楚,讓一個 agent 做完,再讓另一個沒看過過程的 agent 審一次。其他的,等它證明自己有用再加回來。
留言